音訊新聞
Audio-Omni: Extending Multi-modal Understanding to Versatile Audio Generation and Editing
Audio-Omni: Extending Multi-modal Understanding to Versatile Audio Generation and Editing

Audio-Omni:将多模态理解扩展到通用音频生成与编辑的多功能框架
https://ift.tt/dwrc06p
近期在多模态模型方面的进展推动了对音频理解、生成与编辑的快速发展。然而,这些能力通常由专用模型来实现,尚未充分探究开发一个真正统一的框架,能够无缝整合三者。尽管一些开创性工作已探索将音频理解与生成统一起来,但往往局限于特定领域。为了解决这一问题,我们推出 Audio-Omni,这是第一个端到端的框架,能够在通用声音、音乐与语音领域统一生成与编辑,并具备整合的多模态理解能力。我们的架构将一个冻结的多模态大语言模型用于高级推理,与一个可训练的扩散变换器用于高保真合成相结合。为克服音频编辑中的关键数据稀缺问题,我们构建了 AudioEdit,这是一个新的大规模数据集,包含超过一百万对经过精心筛选的编辑对。大量实验表明,Audio-Omni 在一系列基准测试中达到最前沿的性能,优于现有的统一方法,并且在与专门的专家模型相比时表现相当或更优。除了核心能力之外,Audio-Omni 还具备显著的继承能力,包括知识增强的推理生成、上下文内生成,以及对音频生成的零样本跨语言控制等特性,凸显了向通用生成音频智能的一个有希望的方向。代码、模型和数据集将公开发布在 https://zeyuet.github.io/Audio-Omni。
HI-FI 新闻
via Artificial Intelligence https://ift.tt/OsDap2u
2026年4月14日 05:27AM
April 14, 2026 at 05:27AM
-
Product on sale
 Audiophile Vinyl Records Cleaning BundleOriginal price was: €69.90.€59.90Current price is: €59.90. excl. VAT
-
Product on saleEasy Start Vinyl Records Cleaning KitOriginal price was: €69.90.€59.90Current price is: €59.90. excl. VAT
-
Vinyl Records Cleaner Easy Groove Concentrate€34.95 excl. VAT
-
Easy Groove Super Set€199.00 excl. VAT
-
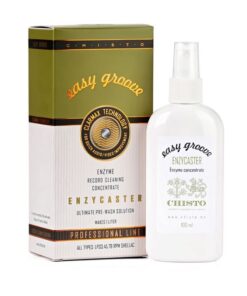
Easy Groove Enzycaster – vinyl records prewash cleaner€34.95 excl. VAT
-
Easy Groove Extreme MK. II- vinyl records prewash cleaner€45.00 excl. VAT
-
Vinyl Records Cleaner – Easy Groove Virgin Concentrate€35.00 excl. VAT
-
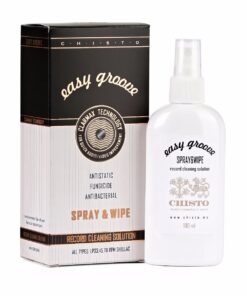
Easy Groove Spray&Wipe vinyl records cleaner€34.95 excl. VAT