音訊新聞
OmniReasoning: Pushing the Limits of Audio-Visual Joint Reasoning
OmniReasoning: Pushing the Limits of Audio-Visual Joint Reasoning

OmniReasoning:推动音视频联合推理的极限
https://ift.tt/b8VuGwC
近来,统一的全模态模型在理解音频、视觉和语言方面取得了进展。然而,现有的基准、训练数据和学习方法在很大程度上把模态视为独立处理,导致音视频联合推理的能力评估不足、激发不足。我们通过基准、数据引擎和学习方法来填补这一空白。首先,我们推出 OmniReasoningBench 这一基准,在该基准中音频和视觉证据都不可或缺。它包含跨两个任务的1,150道选择题与开放式问题,涵盖“对视频进行推理”和“超越视频的推理”。其次,我们开发数据引擎 OmniQA。它自动构建证据支撑的问答对,明确需要音视频联合推理,并附带带时间戳的线索链,指导思维过程的标注。除了我们的基准,该引擎还生成训练数据 OmniReasoning-SFT-112K 和 OmniReasoning-RL-19K。最后,我们提出一种基于策略的自蒸馏方法 Modality-Factored Self-Distillation(MFSD)。它在模态特定线索上下文中评估每个采样回答,分离各线索的贡献及其跨模态交互以进行逐 token 的信用分配。借助我们的训练数据和学习方法,我们的模型 OmniReasoning-30B-A3B 在 OmniVideoBench 上达到 50.0%,在 OmniReasoningBench 上达到 42.5%,分别比基础模型 Qwen3-Omni-30B-A3B-Thinking 提升 12.8 个和 9.3 个百分点。此外,它在通用及长视频基准上也有显著提升,包括 Video-MME-v2。我们希望我们的工作为推动未来在全模态联合推理领域的研究提供扎实的步骤。
HI-FI 新闻
via Takara TLDR – Daily AI Papers https://tldr.takara.ai
2026年10月4日,02:32(AM)
October 4, 2026 at 02:32AM
-
Product on sale
 Audiophile Vinyl Records Cleaning BundleOriginal price was: €69.90.€59.90Current price is: €59.90. excl. VAT
-
Product on saleEasy Start Vinyl Records Cleaning KitOriginal price was: €69.90.€59.90Current price is: €59.90. excl. VAT
-
Vinyl Records Cleaner Easy Groove Concentrate€34.95 excl. VAT
-
Easy Groove Super Set€199.00 excl. VAT
-
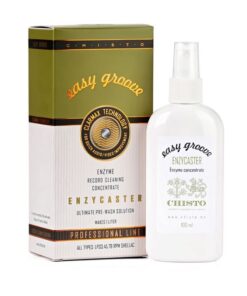
Easy Groove Enzycaster – vinyl records prewash cleaner€34.95 excl. VAT
-
Easy Groove Extreme MK. II- vinyl records prewash cleaner€45.00 excl. VAT
-
Vinyl Records Cleaner – Easy Groove Virgin Concentrate€35.00 excl. VAT
-
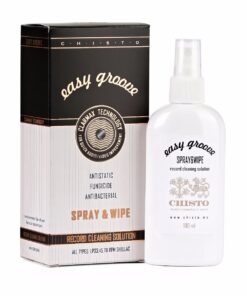
Easy Groove Spray&Wipe vinyl records cleaner€34.95 excl. VAT