Audio-Nachrichten
Peak Human Content: Why 2025 Was the Line
Peak Human Content: Why 2025 Was the Line

Peak Human Content: Warum 2025 die Grenze war
https://ift.tt/TMyEont
Peak human content ist vorbei. Im Jahr 2025 erzeugten Menschen zum letzten Mal die Mehrheit des Inhalts im Internet. Diese Aussage klingt dramatisch. Es ist keine Prophezeiung. Es ist der Konsens unter Forschern, die das Volumen synthetischer Inhalte verfolgen, und sie war eine der zentralen Behauptungen während der jüngsten Ontology Privacy Hour von Juliun, der an Tools zur Rückverfolgung von Inhalten mit Künstlern und Studios arbeitet.
Von diesem Punkt an wird der Großteil neuer Texte, Bilder, Audios und Videos online von KI generiert werden. Menschen werden zwar weiterhin Inhalte erstellen, aber sie werden dauerhaft von Maschinen übertroffen, die Inhalte schneller, billiger und in einem Maßstab produzieren können, den keine Belegschaft erreichen kann.
Dies ist kein bloßes Kuriosum. Es verändert die Grundlagen, wie wir online über Daten, Privatsphäre, Identität und Vertrauen denken. Und es macht die Infrastruktur, die Menschliches von Synthetischem unterscheiden kann, und die Vertrauen an eine reale Person verankern kann, wichtiger denn je.
Was Peak Human Content tatsächlich bedeutet
Das Volumen KI-generierter Inhalte wächst exponentiell. Große Sprachmodelle, Bildgeneratoren, Videosynthese-Tools und Stimmklon-Systeme verbessern sich alle in der Qualität, während die Kosten sinken. Die Barriere, synthetische Inhalte in großem Maßstab zu produzieren, ist effektiv null.
Das Ergebnis ist vorhersehbar. Schätzungen legen nahe, dass bis 2026 über 90% der neuen Online-Inhalte synthetisch erzeugt sein werden. Social-Media-Feeds, Produktbewertungen, News-Kommentare, Forenbeiträge, sogar akademische Arbeiten: Die Default-Annahme für jedes online begegnete Inhaltselement wird zunehmend, dass es nicht von einem Menschen geschaffen wurde.
Dies ist kein Versagen der Moderation oder Plattformpolitik. Es ist eine strukturelle Verschiebung. Die Ökonomie der Inhaltserzeugung hat sich dauerhaft verändert. Eine einzelne Person mit Zugriff auf eine API kann nachmittags mehr Text erzeugen als ein Newsroom in einem Jahr. Die Frage lautet nicht mehr, ob synthetische Inhalte dominieren werden. Sie tun es bereits.
Die Privatsphäre-Inversion
Hier dreht sich die Argumentation in eine gegenintuitive Richtung. Wenn die überwiegende Mehrheit der Inhalte synthetisch ist und wenn synthetische Inhalte zunehmend nicht mehr von menschlicher Arbeit zu unterscheiden sind, dann wird in gewisser Weise alles standardmäßig privat. Ihre echten Daten liegen in einem Ozean von Rauschen versteckt, so groß, dass deren Identifizierung nahezu unmöglich wird.
Wie Juliun während der Privacy Hour sagte: „99% der Daten sind KI-generiert und sie sind nicht von menschlich erzeugten zu unterscheiden. Das heißt, das ist maximale Privatsphäre, oder? Das Einzige, was wirklich gesichert und authentisch verifiziert werden muss, ist, wenn ich sage, dass dies meins ist.“
Dies ist eine echte Umkehr dessen, wie wir in den vergangenen zwei Jahrzehnten über Privatsphäre gedacht haben. Das traditionelle Modell ging davon aus, dass Ihre Daten identifizierbar sind und gesichert, verschlüsselt, zugriffsbeschränkt und auf Anfrage gelöscht werden müssen. Das neue Modell legt nahe, dass die Daten selbst als Identifikator an Wert verlieren. Das, was Wert hat, ist der Moment, in dem Sie Ihr verifiziertes Selbst mit einer Behauptung verknüpfen.
Privatsphäre, in diesem Rahmen, geht nicht darum, Daten zu verstecken. Es geht darum, Attribution zu kontrollieren.
Attribution wird zum Produkt
Wenn Daten Rauschen sind und Identität Signal, dann ist Attribution nicht nur ein Nice-to-have. Sie ist das gesamte Produkt. Juliun illustrierte dies mit einem einfachen Beispiel. Wenn Bloomberg einen Aktienkurs veröffentlicht, hat diese Information Gewicht, weil Bloomberg sie gesagt hat. Wenn ein anonymes Konto dieselbe Zahl in einem Forum postet, hat sie fast kein Gewicht. Die Daten sind identisch. Die Quelle ist alles.
Beschleunigt man diese Logik weiter, entsteht ein überzeugendes Modell. In einer Welt, die von synthetischen Inhalten gesättigt ist, müssen Publisher und Creators ihre Rohausgabe nicht schützen. Sie müssen den Moment schützen, in dem sie etwas mit ihrem Namen versehen. Das Signal, die Attribution, der verifizierbare Link zwischen einem Content-Stück und einer vertrauenswürdigen Quelle: Das ist, wo sich all der Wert konzentriert.
Meta zahlt Künstlern Berichten zufolge bis zu 500.000 US-Dollar pro Tag, um 3D-Modelle für Trainingsdaten zu produzieren, genau deshalb, weil sie authentische menschliche Arbeiten in ihren bestehenden Datensätzen nicht von synthetischer Ausgabe unterscheiden können. Wie Juliun während der Privacy Hour beschrieb: „Sie denken, wie findet man echt? Es ist alles, ich weiß nicht, ob das echt ist oder nicht, ich weiß nicht, ob es gut ist oder nicht, also vielleicht lieber einfach Leute bezahlen, damit sie es machen.“ Die Knappheit an nachweislich menschlichen Inhalten schafft bereits echten wirtschaftlichen Wert.
Der Training-Daten-Ouroboros
Es gibt hier eine Folge hier zweiter Ordnung, die enorm wichtig ist. KI-Modelle, die auf KI-generierten Inhalten trainiert werden, verschlechtern sich. Das ist kein Spekulation; es ist ein dokumentiertes Phänomen namens Model Collapse, bei dem auf synthetischen Daten trainierte Folge-Generationen von Modellen an Vielfalt, Genauigkeit und Kohärenz verlieren. Das Training mit eigener Ausgabe ist ein Ouroboros: Die Schlange frisst ihren eigenen Schwanz.
Dies schafft eine dringende Nachfrage nach authentischen menschlichen Daten. Nicht irgendeinen Datensatz, sondern Daten, die mit hoher Zuversicht als von Menschen produziert verifiziert werden können. Content-Provenance-Systeme wie C2PA (Coalition for Content Provenance and Authenticity) existieren, um einen Teil dieses Problems zu lösen, indem sie Metadaten an Inhalte anhängen, die Herkunft und Verarbeitungsgeschichte festhalten.
Aber wie im vollständigen Privacy Hour Recap diskutiert, hat C2PA ein Fragilitätsproblem. Die Provenance-Metadaten sind in einem Manifest gespeichert, das aus dem Inhalt entfernt werden kann. Sobald sie getrennt sind, gibt es keine Möglichkeit, die beiden wieder miteinander zu verbinden. Die Attribution ist weg. Hier wird die Blockchain-Infrastruktur kritisch: Eine Ankerung der Provenance on-chain schafft eine permanente, unveränderliche Verknüpfung zwischen Inhalt und Ursprung, die sich nicht lösen lässt.
Was dies für Identitätsinfrastruktur bedeutet
Wenn Attribution das Asset ist und Provenance die Mechanik, dann ist die Infrastruktur, die beides ermöglicht, das Fundament. Verifizierbare Identität, die Fähigkeit nachzuweisen, dass eine reale Person hinter einem Content-Stück, einer Transaktion oder einem Datenpunkt steht, wird zur tragenden Infrastruktur der gesamten digitalen Wirtschaft.
Dies ist der Bereich, in dem Ontology seit Jahren aufbaut. ONT ID bietet dezentrale Identität, die es Individuen erlaubt, zu beweisen, wer sie sind, ohne ihre Daten einer zentralen Behörde zu überlassen. Verifizierbare Anrechnungen (Verifiable Credentials) ermöglichen Nutzern, dem Teilen bestimmter Behauptungen über sich selbst zuzustimmen, zu prüfen, wo diese Behauptungen verwendet wurden, und den Zugriff zu widerrufen, wenn sie möchten. ONTO Wallet setzt dies in die Hände der Nutzer als praktisches Werkzeug, nicht nur als Protokoll.
In einer Post-Peak-Human-Welt sind dies keine abstrakten Fähigkeiten. Sie sind die Primitiven, die Attribution, Provenance und Vertrauen in großem Maßstab ermöglichen. Wenn die Frage von „Wie schütze ich meine Daten?“ zu „Wie bewiese ich, dass dies meins ist?“ wechselt, lautet die Antwort dezentrale Identität.
Der menschliche Aufpreis
Es gibt einen optimistischen Faden, der durch all dies hindurchgeht. Wenn menschlich erzeugte Inhalte knapp werden und wenn verifizierte menschliche Attribution wertvoll wird, verschiebt sich die wirtschaftliche Macht wieder zu den Individuen. Nicht zu Plattformen, nicht zu Modellanbietern, sondern zu den Menschen, die beweisen können, dass sie echt sind und dass ihre Arbeit ihnen gehört.
Dies ähnelt nicht dem Wandel bei analogen Gütern in einer digitalen Welt. Vinyl-Schallplatten, handgefertigte Möbel, Filmfotografie: Wenn digitale Reproduktion alles unendlich kopierbar machte, stieg die Prämie auf das authentische Original, nicht auf dessen Verlust. Die gleiche Dynamik spielt sich mit Inhalten und Daten ab, jedoch in deutlich größerem Maßstab und mit deutlich höheren Einsätzen.
Die Infrastruktur, die dies ermöglicht, verifizierbare Identität, On-Chain-Provenance, nutzerkontrollierte Attribution, ist das, was die Zuversicht in eine praktikable Form verwandelt. Ohne sie ist der menschliche Aufpreis nur eine schöne Idee. Mit ihr wird daraus eine Ökonomie.
Wohin das als Nächstes führt
Peak Human Content ist eine Schwelle, kein Ereignis. Wir werden nicht eines Morgens aufwachen und feststellen, dass das Internet umgeschaltet hat. Es ist eine allmähliche Verschiebung, und größtenteils hat sie bereits stattgefunden. Die Frage lautet nun, ob wir die Infrastruktur aufbauen, um die Welt danach zu navigieren, oder ob wir denselben zentralisierten Akteuren, die vom Datensch marketingProfit gewonnen haben, erlauben, von dessen Ersatz zu profitieren.
Ontology arbeitet für die zweite Option. Dezentrale Identität, verifizierbare Zeugnisse, On-Chain-Provenance und ein nutzerbesessenes Datensystem sind keine Zukunftsambitionen. Sie sind lebende Infrastruktur. Die 2026 Roadmap reflektiert diese Dringlichkeit, mit Fokus auf die Erweiterung der Identitätsinfrastruktur, die Vertiefung der ONTO Wallet-Funktionen und den Aufbau der Vertrauensschicht, die ein Internet nach dem Peak Human benötigt.
In einer Welt unendlicher synthetischer Inhalte ist das knappste Gut ein verifizierter Mensch. Das ist der Vermögenswert, um den es sich lohnt, ihn aufzubauen.
Dieser Artikel ist Teil einer Serie, die sich mit Themen aus der Ontology Privacy Hour: Privacy, Data and the Future of AI Data auseinandersetzt. Ganzes Episode auf YouTube ansehen.
eingereicht von /u/Criptorrific
[Link][Kommentare]
HI-FI News
via vinyl records Reddit Alert https://ift.tt/bphorI4
13. April 2026, 12:08 PM.
April 13, 2026 at 12:08PM
-
Product on sale
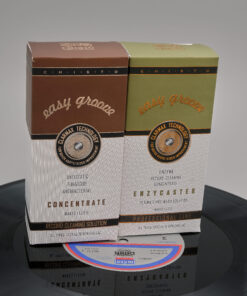
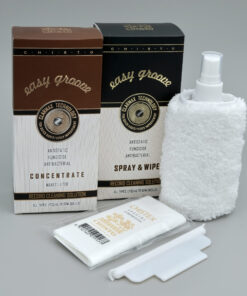
 Audiophile Vinyl Records Cleaning BundleOriginal price was: €69.90.€59.90Current price is: €59.90. excl. VAT
-
Product on saleEasy Start Vinyl Records Cleaning KitOriginal price was: €69.90.€59.90Current price is: €59.90. excl. VAT
-
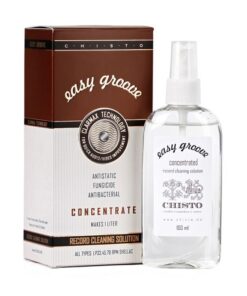
Vinyl Records Cleaner Easy Groove Concentrate€34.95 excl. VAT
-
Easy Groove Super Set€199.00 excl. VAT
-
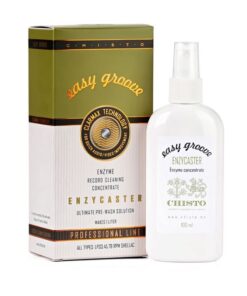
Easy Groove Enzycaster – vinyl records prewash cleaner€34.95 excl. VAT
-
Easy Groove Extreme MK. II- vinyl records prewash cleaner€45.00 excl. VAT
-
Vinyl Records Cleaner – Easy Groove Virgin Concentrate€35.00 excl. VAT
-
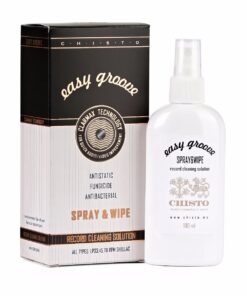
Easy Groove Spray&Wipe vinyl records cleaner€34.95 excl. VAT